

1 引言
临床听力评估急需开发简单可靠的言语感知材料。虽然传统的纯音听阈测试在标准化和操作简便性方面具有优势(Martin & Clark, 2019),但它未能有效评估人类在复杂听觉环境中的言语理解能力(Kramer & Brown, 2021)。日常生活中噪声无处不在,噪声背景下的言语感知能够更真实地反映个体的听力理解和言语交际能力(Plomp, 1978),这一能力理应成为评估听力能力的核心标准。尤其是对佩戴助听器或人工耳蜗的患者来说,准确评估其在噪声环境中的听力表现具有重要临床意义。然而,由于我国相关言语感知研究起步较晚、汉语普通话独有的声调特征和语音特征,普通话言语感知测试材料在标准化、材料种类和数量、信度效度检验及操作规范等方面仍有所欠缺。此外,加上我国地广人众、方言繁杂、言语感知测听技术设备不足等种种因素,导致言语感知测试未能得到有效普及(石颖 等, 2015)。
已有研究表明噪声类型和信噪比是影响言语感知的关键因素。然而,关于不同测试任务在噪声条件下的表现差异及其背后的认知机制,目前尚未得到充分阐明。鉴于此,本研究选取了噪声下言语测试(MHINT; Wong et al., 2007)和中文协调响应测试(CCRM; Wang et al., 2019),通过系统操控噪声类型和信噪比,旨在深入探讨噪声下汉语言语感知的具体机制,以期优化精准听力评估方法,并推动相关测试在实践中的应用和普及。
1.1 噪声下普通话言语感知任务
MHINT和CCRM作为广泛使用的普通话言语感知评估任务,常被用于测定人们在噪声环境中的言语识别能力。其中,MHINT(Wong et al., 2007)是基于英文版HINT编制的汉语标准化测试材料。该测试经过严格的语音平衡设计,全面涵盖了汉语普通话的基本音素分布。多项实证研究已证实其具有较高的信度、效度和敏感度(刘莎 等, 2006; 徐娟娟 等, 2009),但该测试仍面临挑战。主要局限在于它要求被试准确复述句子,这意味着测试结果容易混淆“听力能力”与“语言复述能力”,对语言或认知能力较弱的人群可能不准确。此外,由于测试材料由语义独立的短句构成,被试无法利用大量语篇语境线索,仅能依赖短句有限的上下文和语境信息完成测试。
与MHINT不同,CCRM借鉴CRM句式(Bolia et al., 2000; Brungart, 2001; Eddins & Liu, 2012),采用“姓名+颜色+数字”固定句式的封闭性选择。其语义简单,认知负荷低,适用于包括老人及儿童在内的广大人群;主要依赖声学感知,不受上下文影响,不受语言理解能力影响;封闭式任务适合自适应测试(Kidd et al., 2002; Wang et al., 2019),消除了人工评分误差。综上,MHINT侧重自上而下的语言解码;而CCRM则侧重自下而上的关键词提取,见表1。
表1 CCRM和MHINT任务的特征比较 |
| 特征 | CCRM | MHINT |
| 测试材料 | 句式固定、结构简单、语义有限 | 完整短句、语言自然、音素平衡 |
| 测试任务 | 识别关键词,聚焦特定信息捕捉能力 | 复述整句,评估言语识别能力 |
| 语境使用 | 无法依赖上下文信息或语境信息 | 依赖短句有限的上下文信息和语境信息 |
| 测试目的 | 复杂噪声环境中提取关键词的能力 | 复杂噪声环境中理解句子的能力 |
| 影响因素 | 听觉识别和听觉感知能力 | 听觉感知和加工,依赖语言理解能力、记忆能力和推理能力 |
1.2 噪声类型及掩蔽机制
言语感知主要受到两种噪声掩蔽机制的干扰:能量掩蔽和信息掩蔽(Kidd et al., 2008)。能量掩蔽是指在听觉系统外周,目标信号与掩蔽信号因频谱重叠而产生的竞争性掩蔽。当掩蔽信号的频谱与目标信号重叠时,二者在同一频率通道内形成直接竞争,使得目标信号难以被听觉系统解码(Durlach et al., 2003)。信息掩蔽则是指无法归因于听觉系统外周竞争的掩蔽效应,即排除能量掩蔽影响后仍导致言语可懂度下降的因素(Cooke et al., 2008; Durlach et al., 2003)。
信息掩蔽主要包括两类:语义信息掩蔽(semantic informational masking)(Brungart et al., 2001)和调制信息掩蔽(modulation informational masking)(Conroy & Kidd, 2021)。语义信息掩蔽指当噪声包含语义内容时,其语义成分干扰目标语音的理解。调制信息掩蔽体现在两个方面:(1)掩蔽噪声与目标语音相似的频谱特征和时域包络特征会分散被试的注意力,消耗注意力资源进而干扰目标语音的理解(Freyman et al., 2004);(2)掩蔽噪声的调制特征在时域上和频域上随机变化,其不确定性使得被试无法预测掩蔽释放时机,影响选择性注意在目标信号上的有效分配。Conroy和Kidd(2021)研究表明,相较于固定条件,随机条件(掩蔽调制频率在8~128 Hz范围内随机变化)导致语音目标阈值显著升高,证明了调制不确定性带来的信息掩蔽效应。
本研究考察了三种掩蔽噪声类型:语谱稳态噪声(long-term speech-shaped noise, LTSS)、语谱动态噪声(modulated speech-shaped noise, MSS)和人声噪声(babble noise, BN),形成了系统掩蔽梯度。首先,语谱稳态噪声是基于语音信号的长期平均频谱而生成的噪声类型,其频谱形态与语音类似,不包含语音信息,强度恒定,主要通过能量掩蔽干扰语音感知。其次,语谱动态噪声在保持与语谱稳态噪声相同长时程频谱的基础上,模拟人声噪声的时域包络,通过时域调幅使噪声强度随时间波动,产生双重影响:一方面,理论上产生调制信息掩蔽;另一方面,语谱动态噪声强度在时域上的持续变化在噪声较弱的时段会产生短暂的“时域间隙”(temporal dips),提供相对较高的信噪比瞬时片段,使得语音信号能够短暂降低噪声干扰并被听觉系统识别(Peters et al., 1998),即“片段提取”模型(Cooke, 2006)。
最后,人声噪声由多个说话者的语音信号叠加而成,具有复杂的频谱特征和时域包络,与目标信号在频域和时域两个维度上高度重叠,是最具挑战的噪声类型(Brungart et al., 2001; Kidd et al., 2005)。人声噪声不仅对目标语音的多个频段产生显著的能量掩蔽,还由于其调制特征与目标信号的高度相似性,以及调制不确定性,引发调制信息掩蔽;此外,人声噪声包含丰富的语义内容,会对目标语音感知造成语义信息掩蔽,导致言语识别难度进一步增加。
三种噪声相比较,一方面,语谱稳态噪声与语谱动态噪声在长时程频谱上具有一致性,二者的主要差别在于语谱动态噪声存在时域间隙。语谱动态噪声在理论上存在调制信息掩蔽,同时也含有时域间隙带来的动态掩蔽释放(masking release from temporal modulation)。另一方面,语谱动态噪声与人声噪声在长时程语谱和时域包络上相符,二者的调制信息掩蔽相当,二者的核心区别在于人声噪声包含语义成分,其差值反映了基于语义的信息掩蔽。
现有研究主要聚焦单一噪声或单一感知任务,对动态掩蔽释放和信息掩蔽释放在不同言语理解任务中的具体作用缺乏系统性研究。由此,本研究拟回答以下三个问题:(1)噪声类型和信噪比(语谱稳态噪声、语谱动态噪声、人声噪声)对CCRM和MHINT测试任务的影响有何差异?预期在同等信噪比下,人声噪声环境的言语识别难度最大,语谱动态噪声环境最小。(2)动态掩蔽释放(即语谱稳态噪声和语谱动态噪声之间的差别)和信息掩蔽释放(即语谱动态噪声和人声噪声之间的差别)如何影响两类任务?预期动态掩蔽释放对两类任务影响相似;而信息掩蔽释放对MHINT影响更大,因人声噪声的语义干扰会消耗认知资源,影响语句理解。(3) CCRM和MHINT是否测试相同的言语感知能力?若二者低相关,表明其评估了言语感知的不同维度,这有助于解释不同噪声条件下任务表现差异的潜在机制。
2 研究方法
2.1 被试
本研究共招募了41名大学生被试,其中男生18名,女生23名,平均年龄21.3岁,标准普通话为母语,均具有北方方言背景。所有被试听力正常,双耳纯音听力测试结果显示,在250 Hz至8000 Hz频率范围内的听力阈值均小于20 dB,平均阈值为11.6 dB。
2.2 测试材料
普通话版MHINT测试包含12张测试表,每表包含20个音素平衡的10字短句。被试需进行开放式句子复述。汉语CCRM借鉴了英语ECRM,采用固定句式“请[人名]到[颜色][数字]”,包括4个名字(李婷、王丽、赵华、张军)、4种颜色(蓝色、绿色、红色、黄色)以及10个(1~10)数字,共160句目标刺激。被试从40个选项中选择颜色和数字,随机概率2.5%。所有材料由普通话水平一级乙等的女性说话人在双壁隔音室内(底噪<20 dB SPL)录制。使用SpeechRecorder(6.3.4),采样率44.1 kHz(16-bit),信噪比约50 dB。每句录制两次并优选,全程监控声学参数。所有音频经Praat去除静音、标注,并将均方根值(RMS)归一化至同一水平,保存为独立WAV文件。
2.3 噪声刺激
本研究采用三种掩蔽噪声。语谱稳态噪声基于六人声平均长时程频谱(Li et al., 2016)对高斯噪声滤波生成。该噪声保持了语音的频谱特征,但不包含时域波动。语谱动态噪声通过希尔伯特变换提取人声噪声的时域包络信息,后把这个包络信息叠加到语谱稳态噪声上而生成。它模拟了人声的时域波动(即保留了时域特征),但不含语义信息。人声噪声由三男三女朗读汉语百科内容的录音混合而成,六个说话人信号经功率归一化后叠加并校准。该噪声兼具真实语音的频谱、时域特征及语义信息,对语音识别构成最大挑战。
2.4 刺激呈现
实验在安静的听力实验室内进行,所有刺激仅通过被试的右耳呈现,使用Sennheiser HD 280 PRO专业监听耳机播放。声音刺激的强度经由Larson Davis声级计(Model 2800)在AEC201-A IEC 60319-1耳膜模拟器中进行校准,采用线性加权频带测量,以确保实验的精准可控。所有声音刺激均重采样至24 414 Hz,以与数字信号处理器兼容。刺激呈现由Tucker-Davis Technologies便携式数字信号处理器(TDT RM1)控制,实验程序由Tucker-Davis Technologies信号处理软件SykofizX v2.0操作。
在本研究中,目标语音与背景噪声并非预先混合,而是在实验过程中由信号处理器实时独立控制并播放。噪声领先语音0.5秒。目标语音的声压级固定在65 dB SPL,通过调整噪声强度(69、72、75 dB SPL),设置三种信噪比条件:−4 dB、−7 dB和−10 dB。
2.5 测试过程
实验包括MHINT和CCRM两项言语感知测试,顺序在被试间随机平衡。正式测试提供3个练习试次,整个过程约两小时,完成后给予一定报酬。
MHINT为主观测试,被试需复写完整句子。实验共设置10个条件,包括3种噪声类型×3种信噪比,以及1个安静条件,每个条件20句(总计200句),以正确字数计算准确率。CCRM任务为多项选择(40种组合选一)。被试需完成相同的10个实验条件,总计400试次,以选择正确率计分。所有条件与试次均为随机呈现。
2.6 数据分析
本研究使用lme4包中lmer函数(R Core Team, 2021)构建线性混合效应模型。问题1的固定效应为噪声类型、信噪比和测试任务;问题2的固定效应因素为动态掩蔽释放/信息掩蔽释放、信噪比和测试任务。模型将被试作为随机效应(随机截距和随机斜率)。本研究通过lmerTest包的anova函数进行第三类方差分析,采用Satterthwaite近似方法计算F值和p值,计算$ \eta _{\mathrm{p}}^{2} $ 作为效应量指标。如果交互效应显著,使用emmeans函数进行简单效应两两对比,并采用Bonferroni校正控制多重比较的I型错误率。问题3采用R语言中cor函数进行偏相关分析,计算CCRM和MHINT任务在各噪声条件下的相关系数(r)及显著性水平(p),评估二者的关联强度。
3 结果
3.1 噪声类型和信噪比对言语感知任务的影响分析
3.1.1 主实验:三种噪声条件下的言语感知表现
在安静条件下,CCRM和MHINT的正确率分别为99.5%和99.3%,两者无显著差异(p>0.05)。在噪声条件下,研究考察了噪声类型(人声噪声、语谱稳态噪声、语谱动态噪声)和信噪比(−4 dB、−7 dB、−10 dB)对言语感知的影响。图1展示了各条件的正确率和标准差。结果显示人声噪声条件下,信噪比效应最显著,两类测试的差异最为突出。
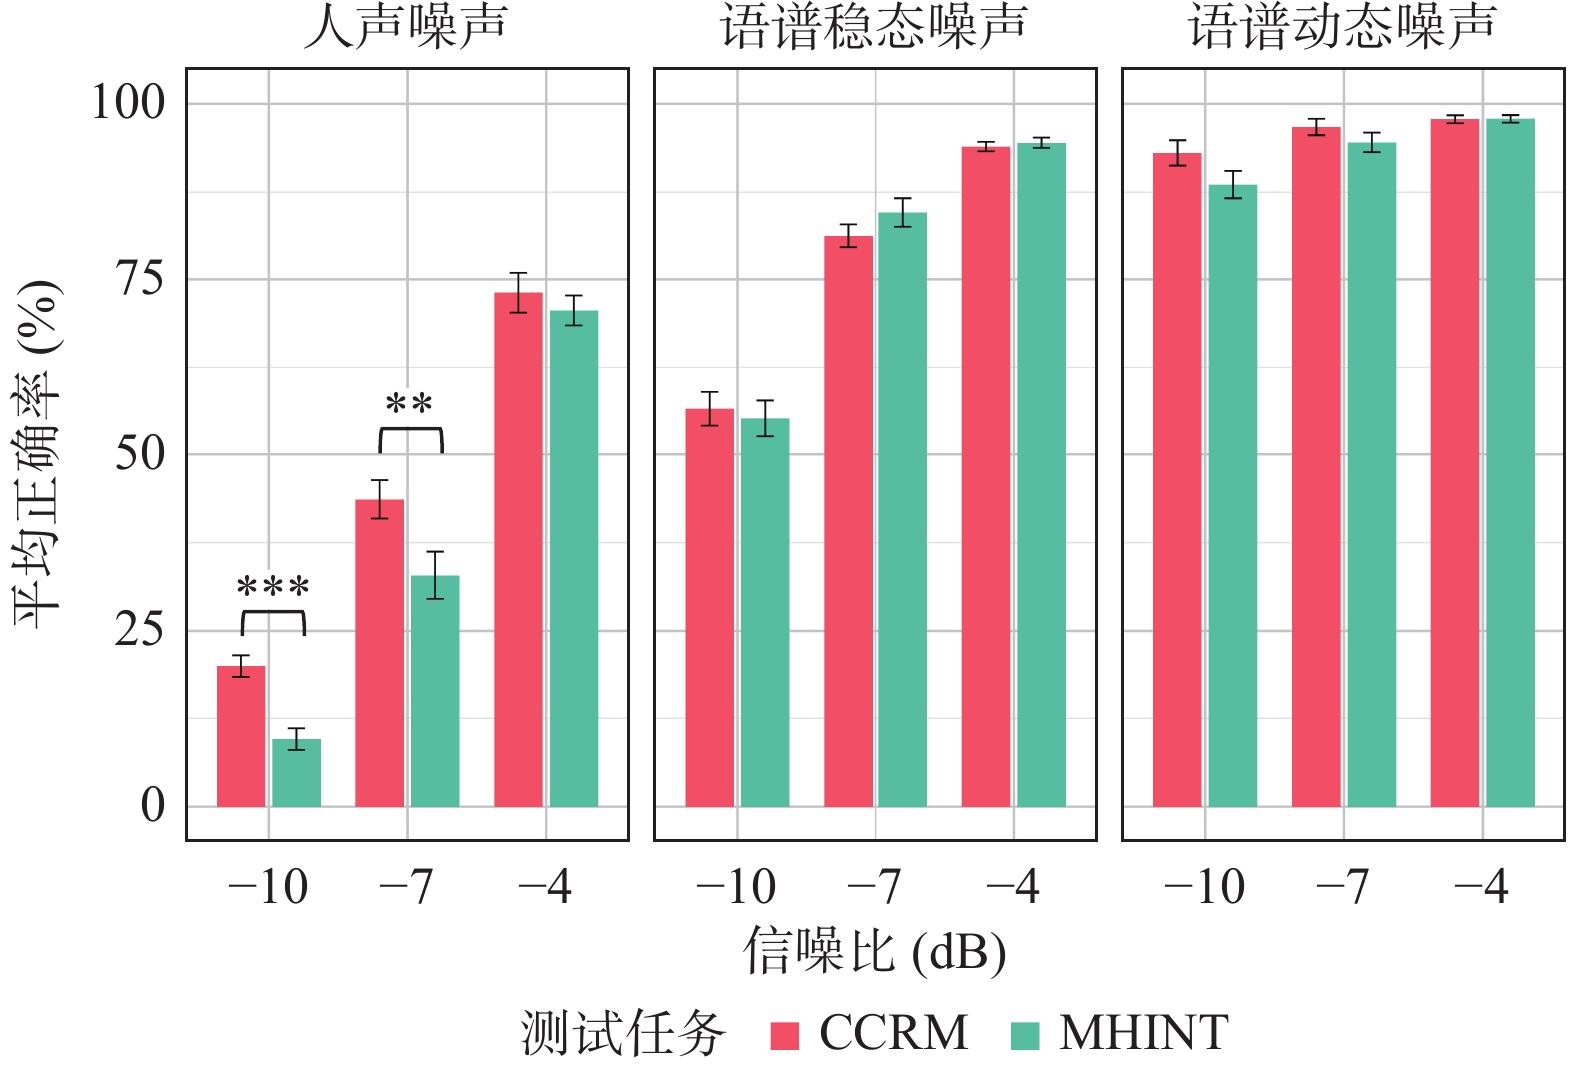
线性混合效应模型显示三个固定因素均有显著主效应:噪声类型[F(2, 679)=1109.55, p<0.001, $ \eta _{\mathrm{p}}^{2} $ =0.83],信噪比[F(2, 679)=382.24, p<0.001, $ \eta _{\mathrm{p}}^{2} $ =0.62),以及测试任务[F(1, 679)=19.68, p<0.001, $ \eta _{\mathrm{p}}^{2} $ =0.04]。噪声类型与信噪比之间[F(4, 679)=71.05, p<0.001, $ \eta _{\mathrm{p}}^{2} $ =0.38]及噪声类型与测试任务之间[F(2, 679)=9.95, p<0.001, $ \eta _{\mathrm{p}}^{2} $ =0.04]的交互作用显著。然而,信噪比与测试任务之间交互作用不显著(p>0.05)。值得注意的是,噪声类型、信噪比和测试任务之间的交互作用显著[F(4, 679)=11.68, p<0.01, $ \eta _{\mathrm{p}}^{2} $ =0.15]。进一步比较发现,在−10 dB和−7 dB条件下,三种噪声两两之间均存在显著差异(ps<0.001);−4 dB条件下,人声噪声和语谱稳态噪声间差异显著(p<0.001),而语谱动态和语谱稳态噪声间无显著差异(p>0.05)。
由于噪声类型和测试任务、噪声类型和信噪比存在显著交互效应,进一步分析了不同噪声类型下测试任务的简单效应。在人声噪声中,测试任务[F(1, 200)=21.79, p<0.001, $ \eta _{\mathrm{p}}^{2} $ =0.10]和信噪比[F(1, 200)=387.98, p<0.001, $ \eta _{\mathrm{p}}^{2} $ =0.80]均具有主效应,且存在交互效应[F(1, 200)=4.51, p<0.05, $ \eta _{\mathrm{p}}^{2} $ =0.02]。具体而言,−4 dB时两类测试任务无显著差异(p>0.05);而−7 dB和−10 dB时,CCRM显著优于MHINT[−7 dB: β=10.73, t(200)=3.68, p<0.001; −10 dB: β=10.31, t(200)=3.54, p<0.001]。在语谱动态噪声条件下,测试任务[F(1, 200)=4.94, p<0.05, $ \eta _{\mathrm{p}}^{2} $ =0.02]和信噪比[F(1, 200)=17.99, p<0.001, $ \eta _{\mathrm{p}}^{2} $ =0.15]有主效应,但二者无交互效应(p>0.05)。在语谱稳态噪声下,仅信噪比有主效应[F(1, 200)=307.22, p<0.001, $ \eta _{\mathrm{p}}^{2} $ =0.75]。研究表明,噪声类型调节了测试任务对信噪比的敏感性:人声噪声中CCRM在−7 dB及更低信噪比下优于MHINT,而语谱动态噪声中测试任务有主效应,语谱稳态噪声中二者无显著差异。
值得注意的是,两类测试任务在语谱噪声(稳态和动态)环境中表现相似,均保持较高正确率(>50%),表明此信噪比条件未充分显现不同噪声类型的差异性影响。前人研究表明,在更具挑战性的听觉环境中,噪声类型的掩蔽效应差异更显著(Brungart, 2001; Mattys et al., 2012)。为探究语谱噪声在极低信噪比条件下的潜在差异及验证动态掩蔽释放效应,本研究设计了更低信噪比(−13 dB和−16 dB)的补充实验。
3.1.2 补充实验:极低信噪比条件下的言语感知表现
主实验的22名(男生10人)被试参与了补充实验,测试材料、测试过程和分析方法与主实验保持一致。图2展示了在−13 dB和−16 dB低信噪比环境中,语谱稳态噪声和语谱动态噪声条件下两类测试任务的平均正确率及标准差。线性混合效应模型分析显示,噪声类型[F(1, 120)=712.12, p<0.001, $ \eta _{\mathrm{p}}^{2} $ =0.84]和信噪比[F(1, 120)=56.78, p<0.001, $ \eta _{\mathrm{p}}^{2} $ =0.29]主效应显著,而测试任务主效应不显著(p>0.05)。测试任务和信噪比的交互效应显著[F(1, 120)=5.68, p<0.05, $ \eta _{\mathrm{p}}^{2} $ =0.04]。然而,噪声类型与测试任务,以及噪声类型与信噪比的交互效应均不显著(ps>0.05)。值得一提的是,噪声类型、信噪比和测试任务之间的交互作用显著[F(1, 120)=8.67, p<0.05, $ \eta _{\mathrm{p}}^{2} $ =0.09]。简单效应分析指出,信噪比−13 dB时测试任务在不同噪声类型中无显著差异(ps>0.05);信噪比−16 dB时,测试任务在语谱动态噪声中无显著差异,但在语谱稳态噪声中,CCRM显著优于MHINT[β=7.26, t(120)=2.02, p<0.05]。
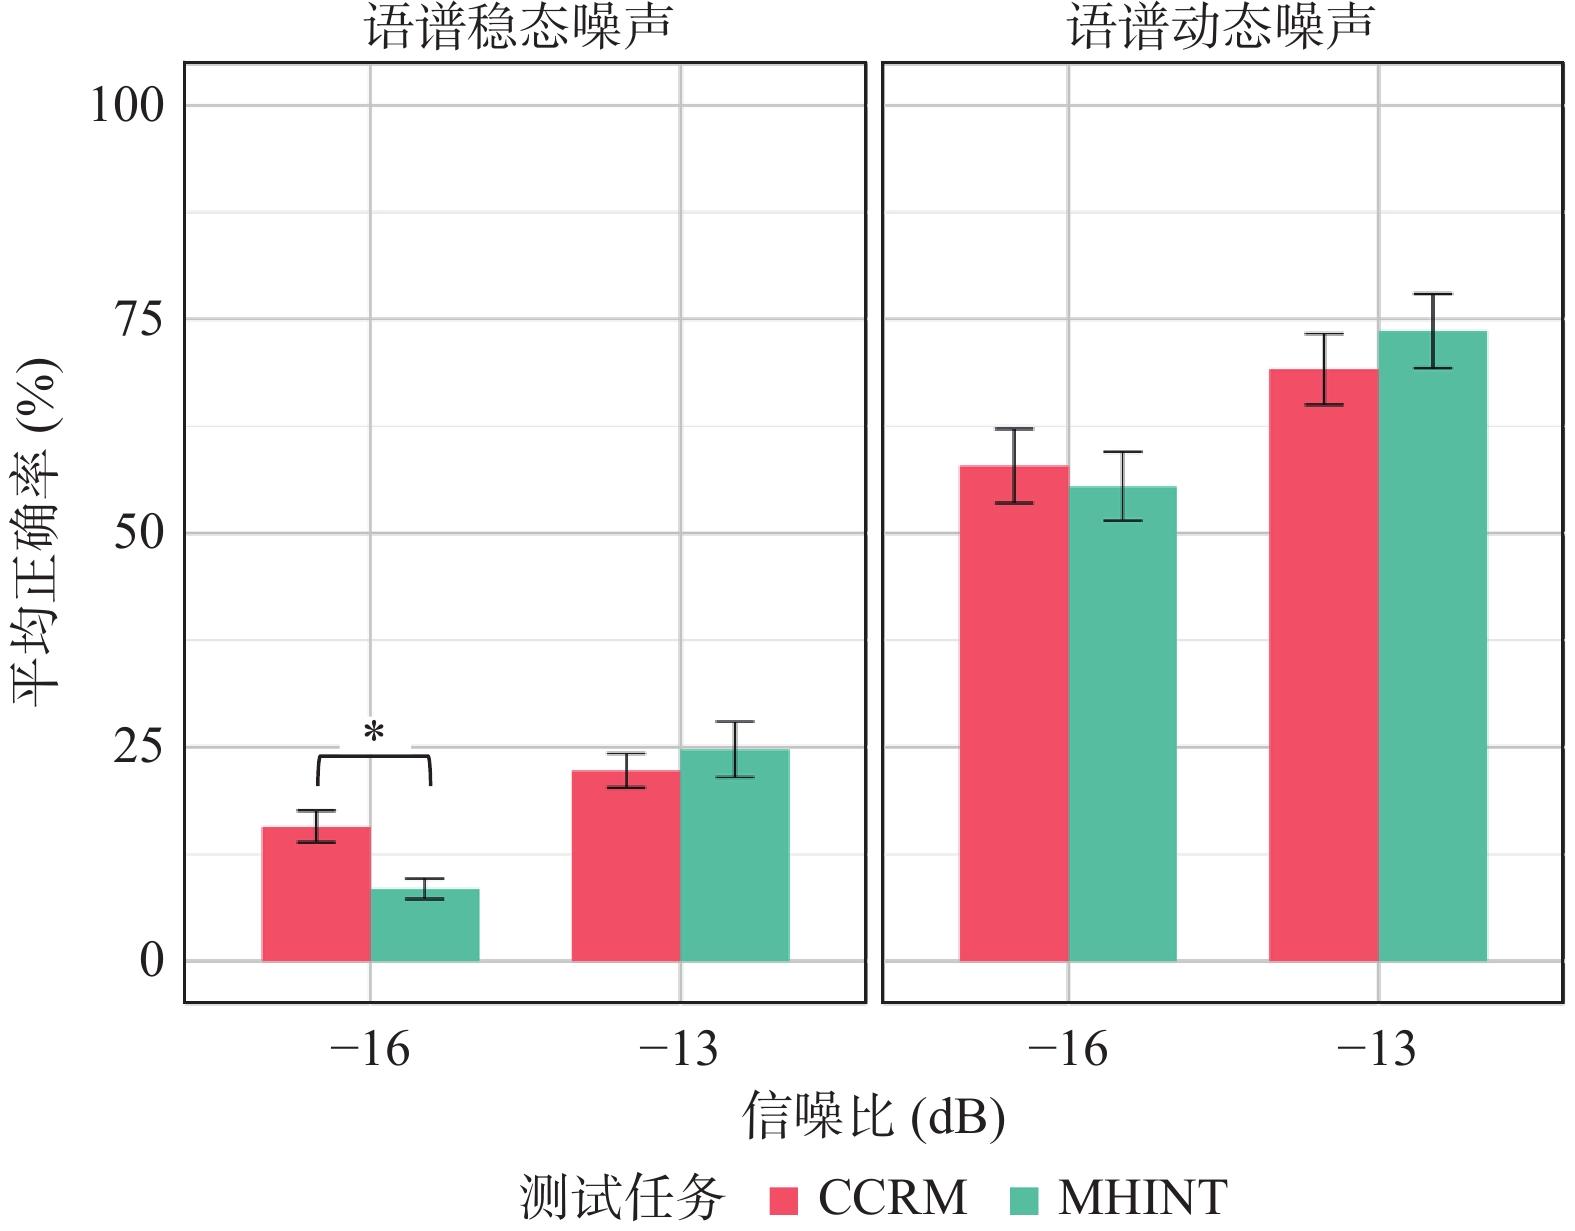
补充实验表明,低信噪比条件下(−13 dB和−16 dB),语谱稳态噪声对言语感知任务影响更大,表现显著低于语谱动态噪声。此外,在−16 dB极低信噪比下,测试任务与噪声类型有交互效应:语谱动态噪声条件下两类任务无差异,而语谱稳态噪声条件下CCRM显著优于MHINT。
3.2 动态掩蔽释放和信息掩蔽释放
图3展示了动态掩蔽释放和信息掩蔽释放对两类测试任务的影响。首先,考察动态掩蔽释放效应,以动态掩蔽释放为因变量,测试任务和信噪比为固定效应,被试为随机效应的混合效应模型分析显示,测试任务无显著主效应(p>0.05),而信噪比有主效应[F(2, 202)=262.23, p<0.001, $ \eta _{\mathrm{p}}^{2} $ =0.56],测试任务和信噪比之间无显著交互效应(p>0.05)。其次,考察信息掩蔽释放效应,以信息掩蔽释放为因变量的混合效应模型分析显示,测试任务有显著主效应[F(1, 202)=8.05, p<0.01, $ \eta _{\mathrm{p}}^{2} $ =0.14],信噪比同样存在显著主效应[F(2, 202)=417.15, p<0.001, $ \eta _{\mathrm{p}}^{2} $ =0.67],两者间无交互效应(p>0.05)。
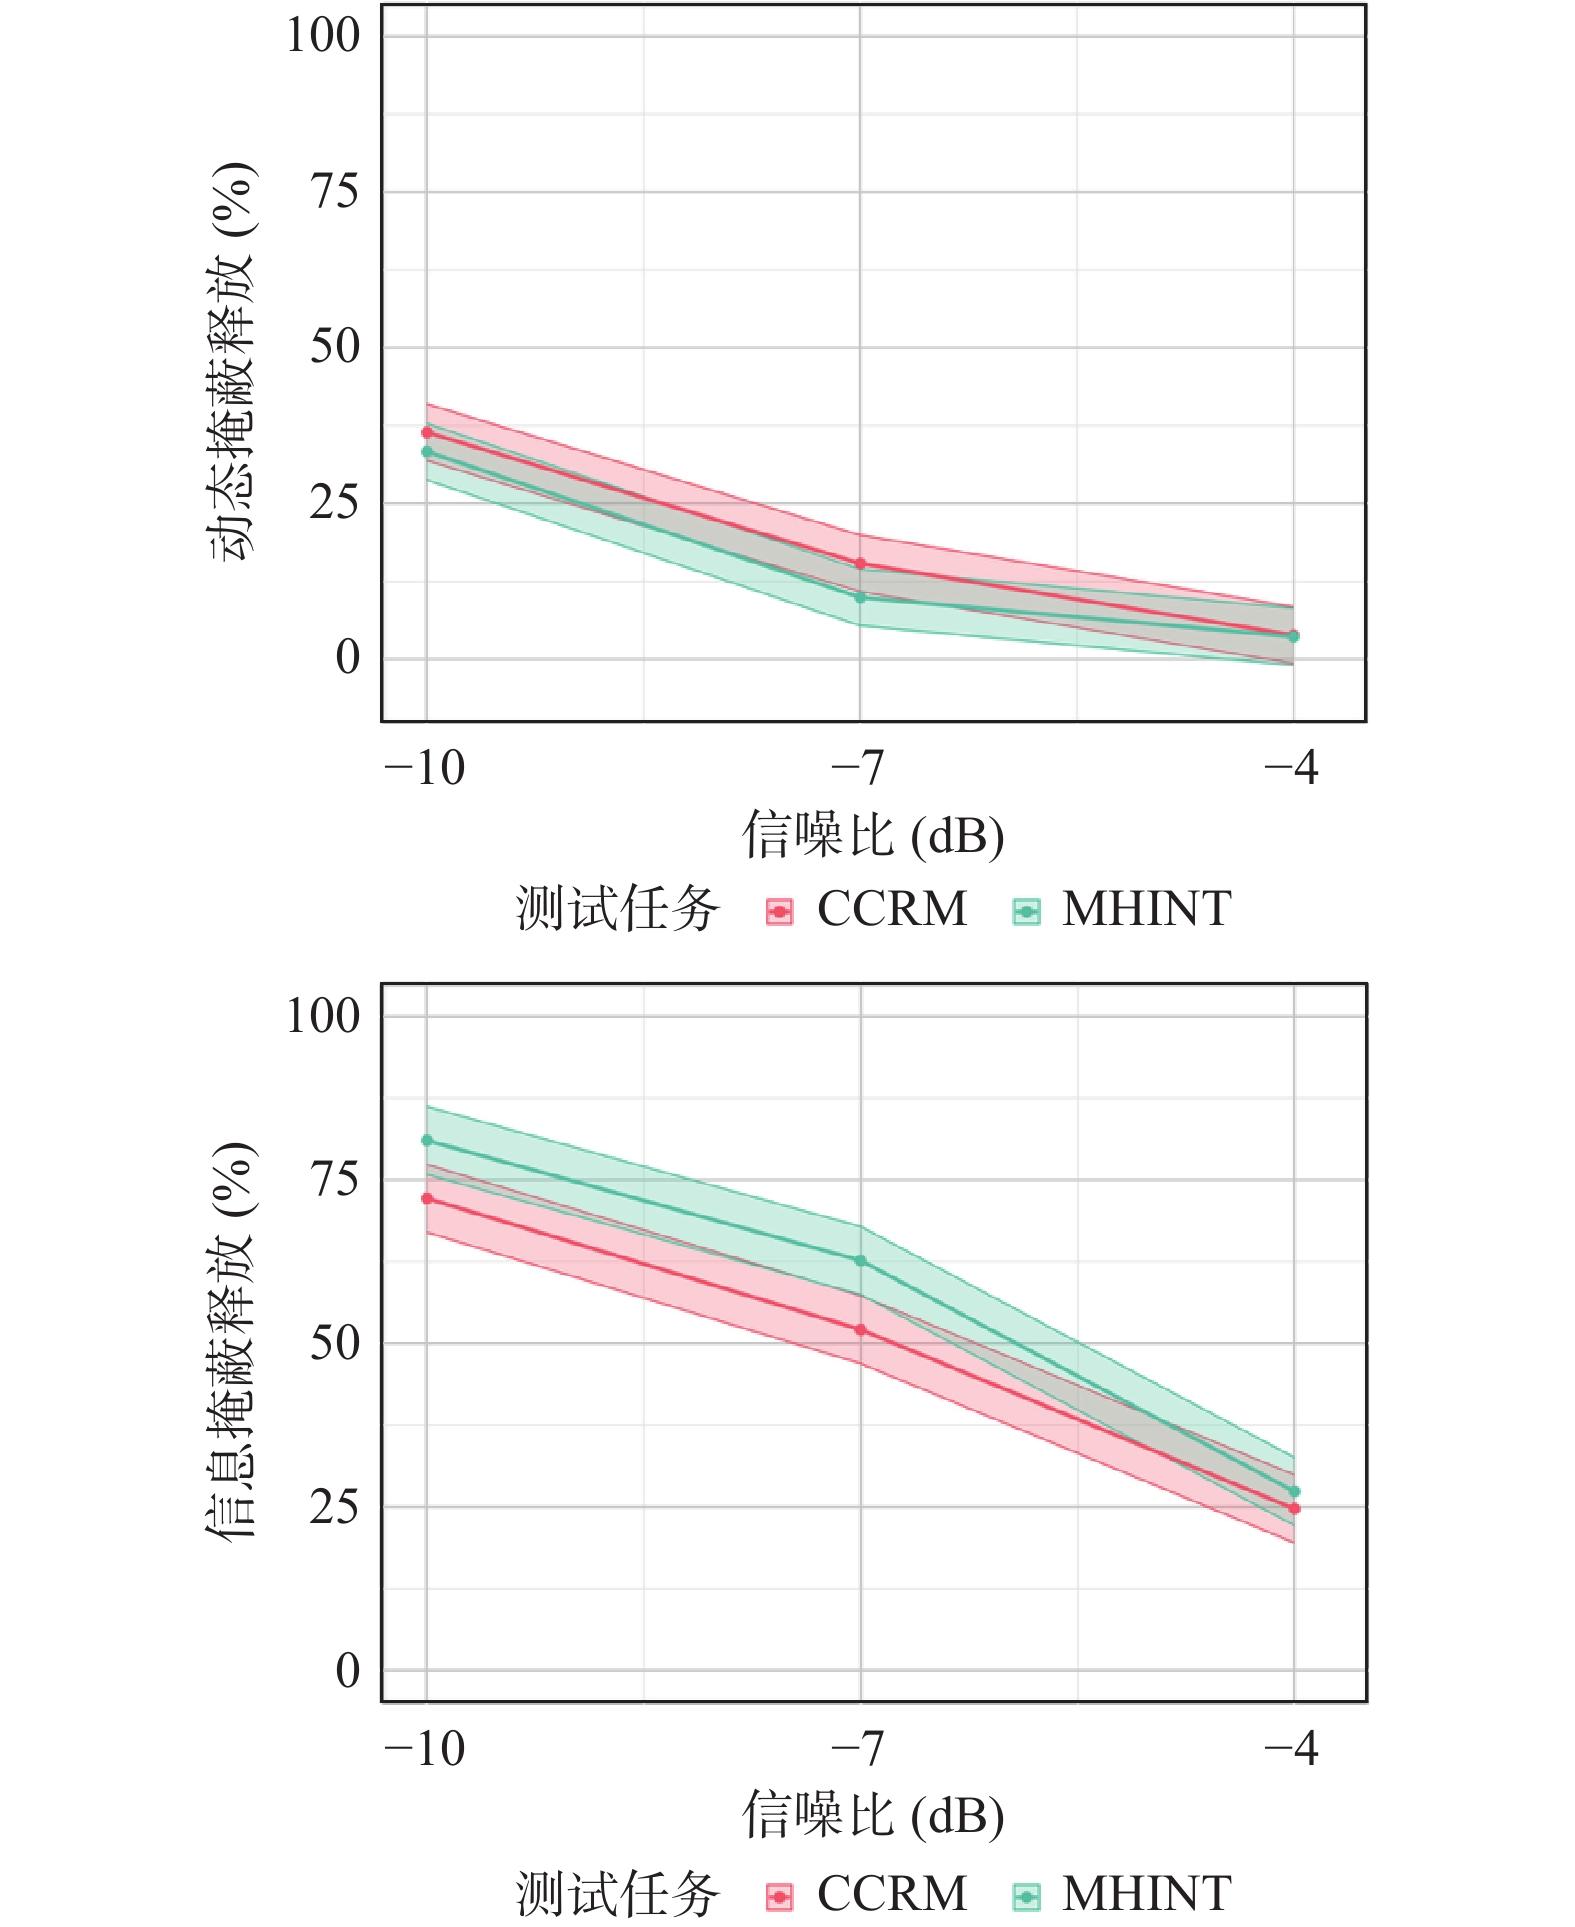
结果说明,动态掩蔽释放对MHINT和CCRM两类任务的影响一致,无显著差异,且主要受信噪比调节。这一发现提示动态掩蔽可能主要影响自下而上的声学线索分离能力,该效应在不同测试任务中表现一致。相比之下,信息掩蔽释放则呈现任务特异性。虽然信噪比仍是主要影响因素,但MHINT任务受到信息掩蔽干扰程度显著强于CCRM(p<0.05)。这一差异可能反映了两类任务在语义处理需求上的不同:MHINT需要理解完整句子语义内容,比CCRM任务更依赖语境整合,因此更易受到人声噪声中语义信息干扰。这表明人声噪声产生的语义干扰强度与任务的高语义整合需求相关,支持信息掩蔽释放效应涉及高级认知过程的观点。
3.3 CCRM和MHINT任务表现的相关分析
图4展示了被试在CCRM和MHINT测试任务中的相关表现。为探究两类任务是否相关,控制信噪比变量进行偏相关分析。结果显示,在安静条件下,由于被试表现接近天花板,两类任务未呈现显著相关性(p>0.05)。然而,在各种噪声条件下,两类任务的表现均呈现显著正相关:人声噪声条件下,偏相关系数为r=0.22,t(120)=2.47,p<0.05;语谱稳态噪声条件下,相关性略有增强[r=0.25, t(120)=2.88, p<0.01];语谱动态噪声条件下,相关性达到最高[r=0.26, t(120)=2.95, p<0.01]。
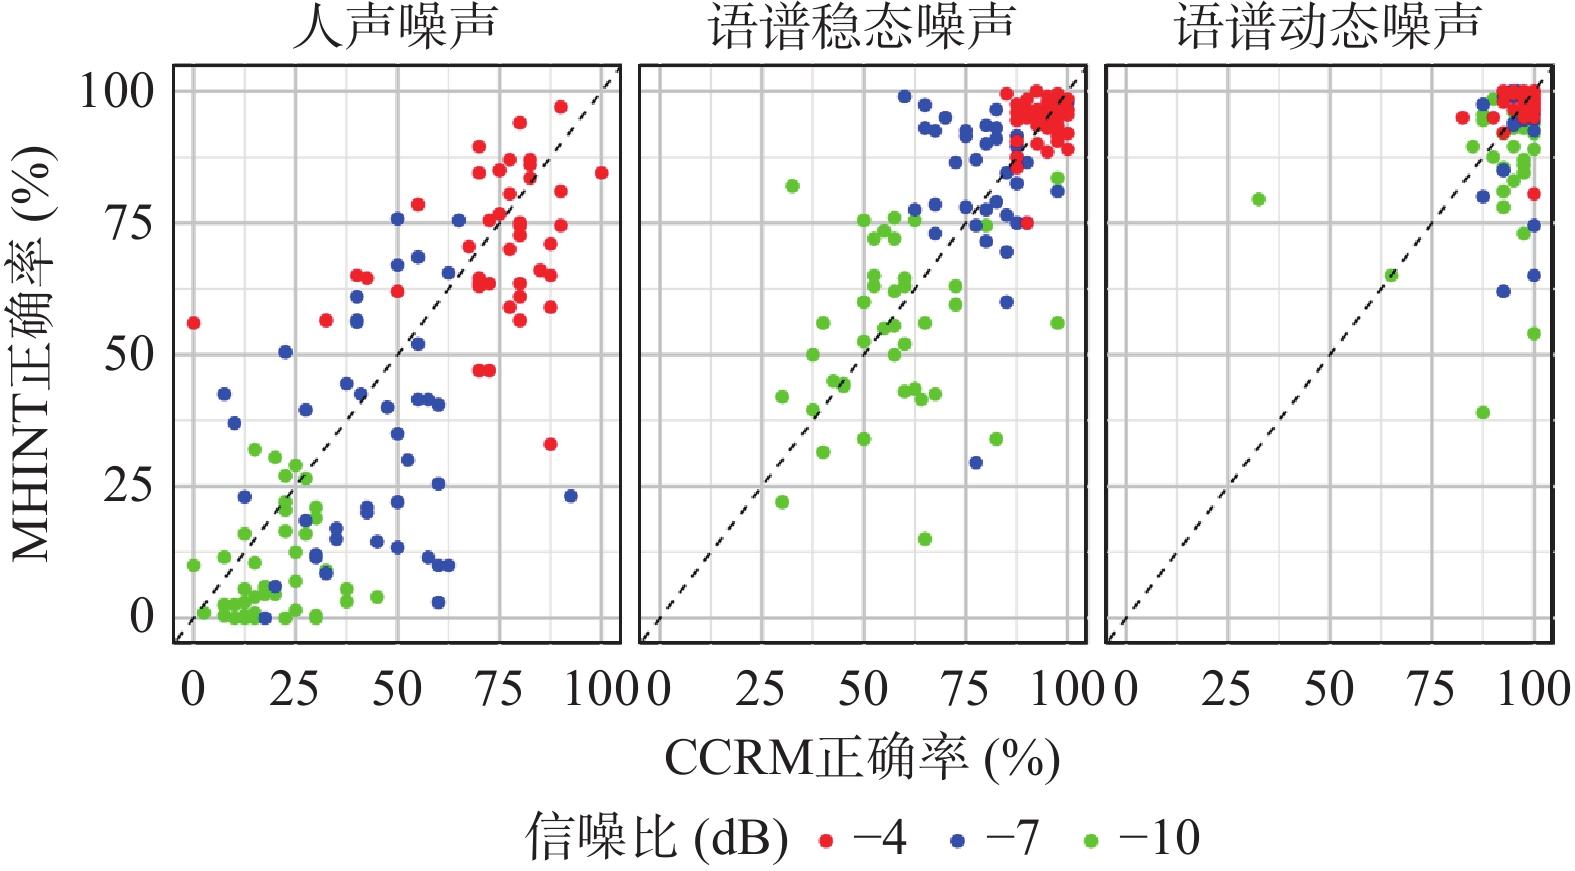


研究发现,两类任务在噪声干扰下表现存在一定的一致性,但相关系数均较弱(rs<0.3),反映共享感知机制有限。CCRM和MHINT可能共享了一些感知机制,但它们仍评估了言语感知的不同层级:CCRM测试有限语境的目标词识别能力,而MHINT则考察句子层面语义整合与理解能力。这两种能力部分依赖于不同的认知资源。
4 讨论
4.1 噪声类型对言语感知测试任务的影响
本研究发现CCRM与MHINT两类任务的差异表现如下:人声噪声条件下,在−7 dB及−10 dB信噪比时,CCRM正确率显著高于MHINT;语谱稳态噪声条件下,仅在极低信噪比(−16 dB)时,CCRM正确率显著高于MHINT;语谱动态噪声条件下,从−4 dB到−16 dB信噪比,两类任务表现无差异。以下从不同噪声类型的掩蔽机制和测试任务的认知需求特性解释这些差异。
首先,人声噪声中,两类任务差异被显著放大。在较低信噪比条件下(−7 dB及以下),MHINT表现显著低于CCRM。从任务特性和噪声机制解释这一差异:MHINT任务较多涉及语义处理,要求被试从噪声中获得语音、语义和句法信息,涉及复杂语言理解过程(Dai et al., 2017)。相比之下,CCRM只需要辨识“颜色词+数字”的有限组合,更多依赖关键词提取能力(Brungart, 2001; Eddins & Liu, 2012)。人声噪声条件不仅通过能量掩蔽降低语音信号可听度,更重要的是通过基于语义的信息掩蔽干扰言语感知:人声噪声中竞争性言语信息诱发了相应语义加工(van Engen & Bradlow, 2007),激活与MHINT任务类似的语言加工通路,干扰目标语音信息的提取;同时,背景人声噪声挤占有限的认知资源(Cooke et al., 2008),削弱目标句的理解能力。简言之,信息掩蔽通过争夺有限的认知资源(如语义整合),对MHINT产生了更大干扰,放大了两类任务间差异。
其次,语谱稳态噪声条件下,仅在极低信噪比(−16 dB)时,CCRM正确率显著高于MHINT。这是因为语谱稳态噪声掩蔽机制较为单一:其平均长期频谱虽与语音部分重叠,但时域上没有波动性(Byrne et al., 1994),主要通过能量掩蔽降低语音信号整体信噪比,对两类任务的干扰较为均衡。然而,在极低信噪比条件下,CCRM凭借其闭集选择任务特性(有限选项、明确关键词)表现优于MHINT。
最后,语谱动态噪声条件下,从−4 dB到−16 dB信噪比范围内,两类任务表现无显著差异。这可能主要归因于时域调制噪声的波动性带来的“时域间隙”效应(Cooke, 2006):在噪声强度瞬时降低的间隙,听觉系统可短暂捕捉语音片段,这种片段化信息的提取能显著提升语音识别能力,对两类任务均有益处。即使在补充实验中更具挑战的噪声条件下,这种效应也使两类任务表现保持相近水平。
4.2 动态掩蔽释放和信息掩蔽释放对言语感知的影响
本研究发现,动态掩蔽释放效应呈现跨任务相似性:对MHINT和CCRM任务无显著差异,且主要受到信噪比调节。语谱噪声主要通过能量掩蔽干扰语音信号,动态噪声通过噪声的时域调制特性可产生信噪比提升的瞬时窗口,“时域间隙”能够短暂恢复基频、共振峰等关键声学特征的解析(Brungart, 2001)。语音信号中声学线索的加工能力是语音感知的基础加工阶段,无论任务是否需要高阶语义整合(MHINT)或仅需声学特征匹配(CCRM),二者均受益于动态掩蔽释放带来的声学信号输入质量的改善(如语音可听性的改善)。因此,动态掩蔽释放为两类任务带来了共享的感知增益,该效应在两类任务中无差异。
然而,需要特别指出的是,语谱动态噪声具有双重效应:一方面通过“时域间隙”提供掩蔽释放增益,另一方面由于其调制特征与目标信号的相似性,可能引入调制信息掩蔽。本研究未能系统控制调制频率和深度,难以准确量化调制信息掩蔽的效应。尽管如此,本研究仍观察到显著的动态掩蔽释放效应,说明时域间隙带来的感知增益超过了调制域信息掩蔽的负面影响。未来研究可以进一步控制调制参数(如固定调制频率和深度; Conroy & Kidd, 2021),量化调制信息掩蔽的干扰,深入探究动态掩蔽释放在两类任务中的表现。
同时,本研究的信息掩蔽主要是基于语义干扰,即人声噪声中语义内容对目标语音理解的干扰。研究发现信息掩蔽效应具有任务异质性:其对MHINT任务的干扰显著强于CCRM任务,且干扰强度与语义整合需求正相关。MHINT任务需要整合句子层面的语义信息,其语义加工高度依赖认知系统对竞争性语义线索的抑制与选择(如抑制噪声中的语义干扰);而CCRM任务仅需词汇识别,对语义资源的占用较低。人声噪声中的语义内容会激活与目标句重叠的语义网络(如相似话题或词汇),从而消耗认知系统的额外资源,干扰目标语义的理解(Mattys et al., 2009)。认知加工资源竞争在需要深度语义整合的MHINT任务中尤为显著,表明语义信息掩蔽的本质是“自上而下”语言处理能力的超载,而非单纯声学层面的冲突(Cooke et al., 2008)。
4.3 临床评估的启示
本研究结果对听力临床评估具有重要启示。首先,研究揭示了单一维度评估的局限性。传统听力评估多专注于纯音阈限,而忽视了复杂噪声环境下的言语识别能力。本研究证实CCRM和MHINT任务间存在弱相关性,表明二者评估了言语感知的不同维度(如关键词提取和复杂语义理解)。因此,在临床应用中,应互补使用这些任务,而非相互替代,以获得对患者言语识别能力的全面评估。其次,本研究强调了多噪声环境中进行评估的必要性。语谱稳态噪声适用于评估基础声学解码能力,语谱动态噪声反映听者利用“时域空隙”的能力,而人声噪声则最接近真实社交环境的挑战。鉴于真实环境中存在多种掩蔽机制的复合作用,建议未来临床听力评估体系应纳入多元背景噪声,从能量掩蔽、动态掩蔽、调制及语义信息掩蔽等多个维度综合评估患者的听觉功能,以便准确地预测个体在复杂声学场景中的实际表现。
5 结论
本研究通过对比不同噪声类型和信噪比条件下的关键词识别(CCRM)与语句理解(MHINT)任务的表现,揭示了掩蔽机制对言语识别的差异化影响。研究发现,不同掩蔽机制对言语感知任务影响的异质性:语义信息掩蔽显著加剧了任务间差异,对高语义需求任务的干扰更为突出,动态掩蔽释放效应在两类任务中呈现普遍性感知增益,而能量掩蔽释放效应仅在极低信噪比条件下导致任务间差异。这表明,关键词识别与语句理解任务评估了言语感知的不同维度,二者间存在弱相关性,为听力临床评估中多元测试提供了理论依据。